Artikel unserer Co-Founderin Ariane in IM+io
Beitrag・4 min
Artikel für IM+io des August-Wilhelm-Scheer-Instituts unserer Mitgründerin Ariane Scheer-Danielsson über die Notwendigkeit eines Trust Layers für Physical AI.
C2PA-Demos sind einfach, solange das Eingangsmedium ein kompaktes JPEG ist. Die ingenieurtechnischen Hürden beginnen dort, wo die Ausführungsumgebung ein mobiler Browser und das Asset ein mehrere Gigabyte großes Video ist. Die Datei lässt sich im Browser nicht am Stück in den Arbeitsspeicher laden, nicht in einem Durchgang hashen, und das nachträgliche Einbetten des Manifests verschiebt physisch jeden einzelnen Byte-Offset im Container. Dieser Beitrag erläutert, wie unsere Asset-Schicht diese drei Herausforderungen meistert. Denn Drohnenaufnahmen, Dashcam-Mitschnitte und Schadenvideos aus dem Außendienst fallen in der Praxis selten in Demo-Größen an.
Ganze Dateien im Hauptspeicher zu puffern funktioniert nur bis zu einer harten Grenze. Ein 2-GB-Video in einem mobilen Browser-Tab provoziert unweigerlich den Absturz der Webanwendung. Der Out-of-Memory-Kill erfolgt unter iOS völlig lautlos und unter Android schlagartig; in keinem der beiden Fälle fängt ein klassischer JavaScript-Try-Catch diesen Prozessabbruch ab.
Aus diesem Grund berührt der Manifest-Code in unserer C2PA-Bibliothek die physische Datei niemals direkt. Er interagiert ausschließlich über ein schlankes Interface namens AssetDataReader, das vier Grundfunktionen bündelt: Bereichslesezugriffe (range reads), das gezielte Ersetzen von Abschnitten, das Zusammensetzen virtueller Blobs und das Schreiben in Ausgabeströme:
interface AssetDataReader { getDataLength(): number; getDataRange(start?: number, length?: number): Promise<Uint8Array>; getBlob(): Promise<Blob>; writeToStream(stream: WritableStream<Uint8Array>): Promise<void>; replaceRange(position: number, data: Uint8Array): void; assemble(parts: AssemblePart[]): AssetDataReader;}Jedes Containerformat (JPEG, PNG, MP4, HEIF oder MP3) implementiert dieses Interface. Die Signatur-Pipeline muss zu keinem Zeitpunkt wissen, welches konkrete Dateiformat sie gerade verarbeitet. Diese einzige Abstraktion ist das Fundament für die gesamte Streaming-Architektur.
Die Klasse BlobDataReader modelliert eine Mediendatei als geordnete Liste von Segmenten. Jedes Segment ist entweder ein lazy evaluierter slice (eine bloße Referenz in das ursprüngliche Quell-Blob mit Start-Offset und Länge) oder ein eifrig allokierter data-Puffer mit neuen oder modifizierten Bytes:
type Segment = { start: number; length: number } & ( | { type: 'slice'; blob: Blob; blobStart: number } | { type: 'data'; data: Uint8Array });Wird ein Datenbereich ersetzt (um beispielsweise ein Manifest einzufügen oder zu aktualisieren), wird die Segmentliste gespleißt: Das Segment vor dem Ersetzungsbereich wird verkürzt, die neuen Daten als Speicherpuffer eingefügt und das darauffolgende Segment entsprechend angepasst. Die originalen Mediendaten werden dabei niemals im RAM dupliziert. Die Segmentliste wächst pro Ersetzung um höchstens zwei Einträge, während die großen Videoblöcke als Zeiger auf das Quell-Blob verbleiben.
Beim Herausschreiben des Ergebnisses streamt die Methode writeToStream die Daten in Blöcken von 64 MB über einen WritableStream:
async writeToStream(stream: WritableStream<Uint8Array>) { const CHUNK_SIZE = 64 * 1024 * 1024; // 64 MB const writer = stream.getWriter(); for (const seg of this.segments) { if (seg.type === 'data') { await writer.write(seg.data); } else { let offset = 0; while (offset < seg.length) { const chunkSize = Math.min( CHUNK_SIZE, seg.length - offset); const slice = seg.blob.slice( seg.blobStart + offset, seg.blobStart + offset + chunkSize); await writer.write( new Uint8Array(await slice.arrayBuffer())); offset += chunkSize; } } } await writer.close();}Zu keinem Zeitpunkt existiert die vollständige Videodatei im flüchtigen Speicher. Die einzigen aktiven Puffer sind der 64-MB-Streaming-Chunk sowie die überschaubaren Datenpuffer der Ersetzungen (das signierte C2PA-Manifest umfasst typischerweise wenige Kilobyte bis wenige hundert Kilobyte). Technisch präzise gesprochen handelt es sich um eine speicherbegrenzte (bounded-memory) und nicht um eine speicherfreie Architektur: Der Speicherverbrauch ist nach oben durch die Chunk-Größe zuzüglich der Manifestgröße strikt gedeckelt.
Besonders leistungsfähig ist die Methode assemble. Wenn der Container-Parser für JPEG oder BMFF die interne Struktur neu ordnen muss (um Platz für Manifest-Boxen zu schaffen), generiert er eine Liste von AssemblePart-Objekten. Jeder Teil verweist entweder auf neue Rohdaten oder auf einen Offset innerhalb der Quelldatei. Der BlobDataReader erzeugt daraus eine neue Segmentliste, ohne die eigentlichen Videodaten ein einziges Mal in den Speicher zu laden:
if (part.sourceOffset !== undefined && part.length) { // Lazy reference to original source blob newSegments.push({ type: 'slice', start: part.position, length: part.length, blob: this.sourceBlob, blobStart: part.sourceOffset, });}Das Neuanordnen des physischen Layouts einer 2-GB-Datei ist somit eine O(n)-Operation über die Teileliste und kein speicherintensives Kopieren über Gigabytes hinweg.
C2PA-Hash-Assertionen müssen per Definition diejenigen Byte-Bereiche überspringen, in denen das Manifest selbst platziert wird. Die Spezifikation bezeichnet diese Bereiche als Exclusion Ranges. Würde das Manifest sich selbst mit hashen, entstünde ein unlösbarer Zirkelschluss. Die Hilfsfunktion hashWithExclusions sortiert alle Ausschlüsse, durchläuft die dazwischenliegenden Nutzdatenbereiche in 1-MB-Abschnitten und speist einen Streaming-Digest:
static async hashWithExclusions( asset: Asset, exclusions: HashExclusionRange[], algorithm: HashAlgorithm,): Promise<Uint8Array> { exclusions.sort((a, b) => a.start - b.start); const digest = Crypto.streamingDigest(algorithm); const CHUNK_SIZE = 1024 * 1024; // 1 MB let currentPosition = 0; for (const exclusion of exclusions) { // Hash data up to this exclusion if (exclusion.start > currentPosition) await processRange(currentPosition, exclusion.start - currentPosition); // Handle offset markers (BMFF-specific) if (exclusion.offsetMarker) { const offsetBytes = new Uint8Array(8); new DataView(offsetBytes.buffer) .setBigInt64(0, BigInt(exclusion.start), false); digest.update(offsetBytes); currentPosition = exclusion.start; } else { currentPosition = exclusion.start + exclusion.length; } } // Hash remaining data await processRange(currentPosition, asset.getDataLength() - currentPosition); return digest.final();}Die Behandlung von offsetMarker ist eine spezifische Finesse des BMFF-Formats: Die V2-Hash-Spezifikation verlangt, dass bestimmte Positionen im Container (der Beginn der jeweiligen Exclusion) nicht einfach ausgelassen, sondern durch ihren 64-Bit-Offset-Wert im Digest ersetzt werden. Wird dieses Detail übersehen, erzeugt man einen formal gültigen Hash über die falschen Daten, was in der Praxis weitaus schwerer zu lokalisieren ist als ein klarer Laufzeitfehler.
Ein wichtiges Web-Detail: Die Standard-Web-Crypto-API unterstützt bis heute kein inkrementelles Hashen. crypto.subtle.digest akzeptiert nur vollständige Puffer und bietet kein Update/Final-Muster. Wir setzen für das Streaming-Hashen auf @noble/hashes. Unser Krypto-Provider kapselt diesen Zugriff vollständig. Auf nativen Plattformen wie React Native leitet derselbe Methodenaufruf direkt an optimierte native Routinen weiter.
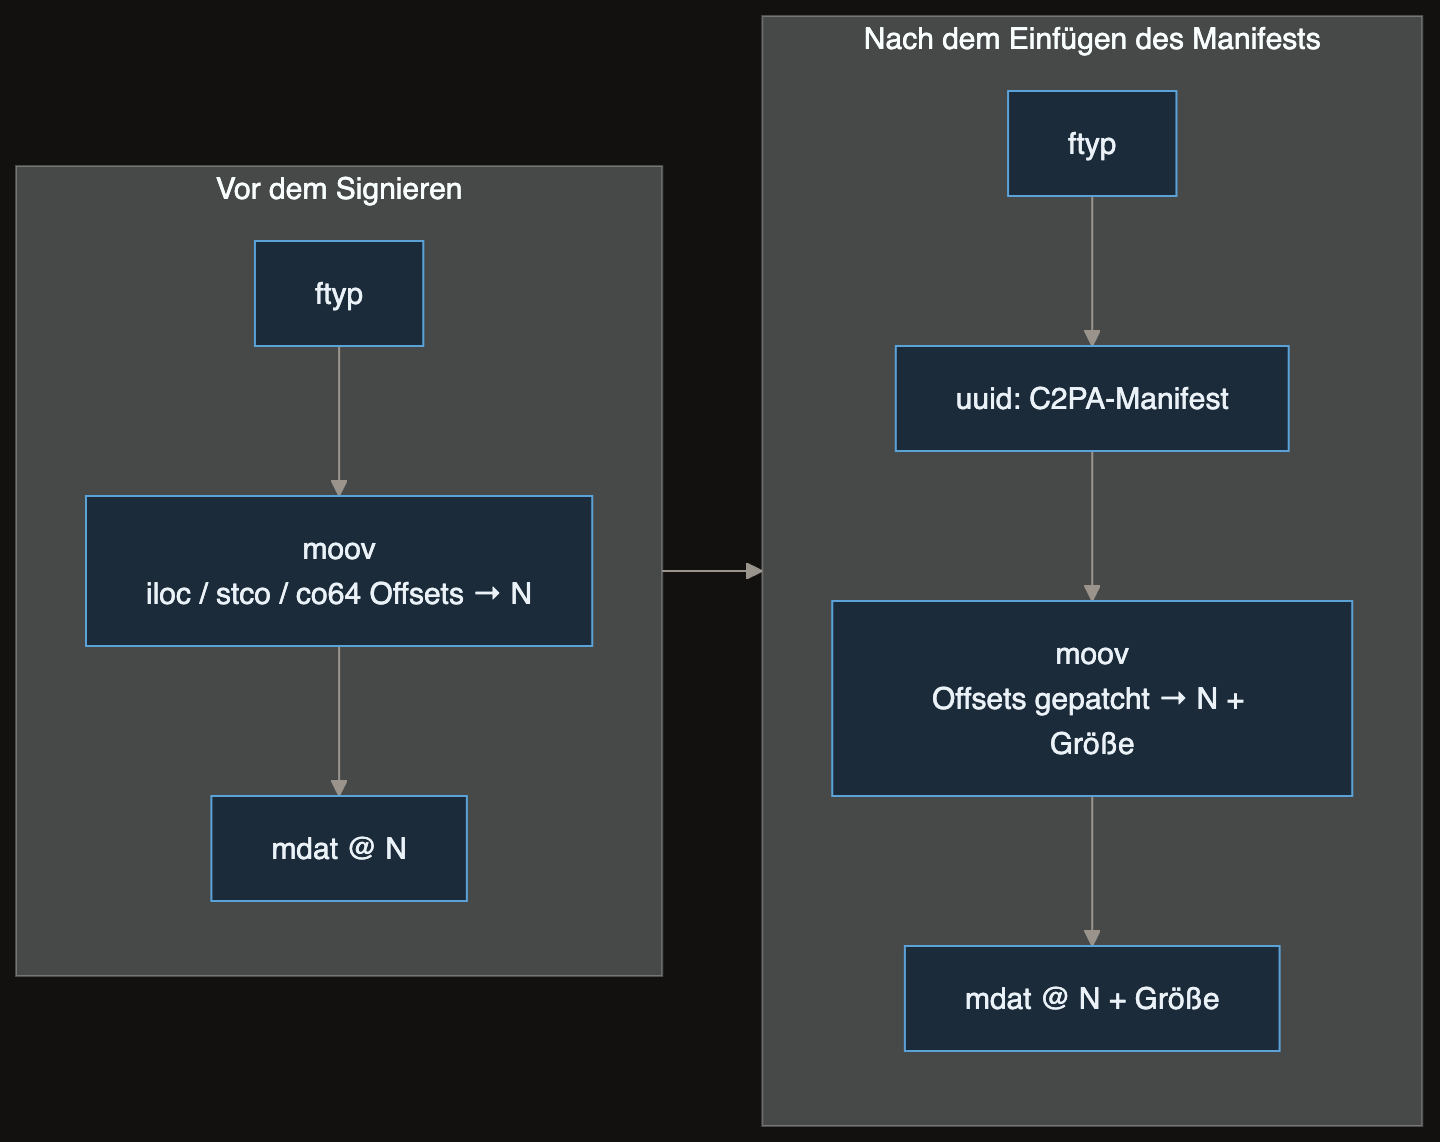
MP4 und HEIF sind modular aus Boxen aufgebaut (BMFF, ISO Base Media File Format). Das Einfügen eines C2PA-Manifests bedeutet, die Box-Hierarchie physisch umzubauen: Vorhandene C2PA-Boxen müssen lokalisiert und entfernt, die Größe des neuen Manifests ermittelt und die neue UUID-Box unmittelbar nach ftyp platziert werden. Unser Parser arbeitet hier strikt lazy: Große Medien-Boxen werden nur anhand ihrer Dateiposition und Länge registriert, ohne ihren Inhalt zu analysieren. Eine 2-GB-Datei zu parsen erfordert daher nicht das Einlesen von 2 GB Daten.
Hier scheitern naive Parseransätze: Das Verschieben von Bytes versetzt die Position von mdat, dem tatsächlichen Medien-Payload. Zahlreiche BMFF-Strukturen speichern jedoch absolute Byte-Offsets innerhalb der Gesamtdatei:
stco: Sample Table Chunk Offsets (32-Bit). Jeder Audio- und Video-Chunk besitzt einen festen Byte-Offset.co64: Chunk Offset 64-Bit. Kommt bei Dateien über 4 GB oder je nach Encoder-Einstellung generell zum Einsatz.iloc: Item Location. Dient in HEIF-Dateien dazu, Bilder und Metadaten innerhalb der Datei zu adressieren.Fügt man Manifest-Bytes ein, ohne diese Offsets im Header anzupassen, erhält man ein signiertes, kryptografisch einwandfreies C2PA-Manifest an einem Video, dessen Tonspur verzerrt ist, das beim Vor- und Zurückspulen falsche Frames anzeigt oder sich gar nicht mehr abspielen lässt. Die Signatur verifiziert fehlerfrei, aber das Video ist unbrauchbar. Kein C2PA-Validator der Welt schlägt hier Alarm, da Validatoren den Videostream nicht wiedergeben.
Unsere Methode containsOffsetSensitiveData durchsucht die Box-Bäume rekursiv nach diesen sensiblen Strukturen:
private containsOffsetSensitiveData(box: Box<object>): boolean { if (['stco', 'co64', 'iloc'].includes(box.type)) return true; for (const child of box.children ?? []) if (this.containsOffsetSensitiveData(child)) return true; return false;}Wird festgestellt, dass offset-sensitive Daten hinter dem Einfügepunkt liegen, werden alle absoluten Offsets um die exakte Byte-Länge des eingefügten Manifests nach oben korrigiert. Die Alternative – ein vollständiges Re-Encoding des Videos – scheidet im mobilen Webbrowser ohne FFmpeg von vornherein aus.
JPEG-Dateien transportieren Manifeste in APP11-Segmenten (Marker 0xEB) nach dem Standard JPEG XT. Weil das Längenfeld eines JPEG-Segments auf 16 Bit beschränkt ist (maximal 65.531 Bytes Nutzlast), wird das Manifest über mehrere APP11-Segmente verteilt. Eine Box-Instanz-ID sowie Sequenznummern verknüpfen die Teilstücke miteinander.
Unser Parser liest Segmente bis zum Start-of-Scan-Marker (0xDA), an dem die komprimierten Bilddaten beginnen und Header-Segmente enden. Der JUMBF-Inhalt wird zusammengesetzt und validiert: Die Sequenznummern müssen lückenlos aufsteigend sein, die Längen exakt passen und es darf nur ein aktiver C2PA-Store existieren.
Um Platz für das Manifest zu schaffen, werden bestehende APP11-Segmente entfernt, die benötigte Segmentanzahl für das neue Manifest berechnet, Dummy-Segmente hinter APP0 reserviert und die Datei neu aufgebaut. Im Gegensatz zu BMFF entfällt bei JPEG das Patchen von Offsets, da das Format keine absoluten Datei-Offsets nutzt. Die Komplexität liegt hier rein im sauberen Aufteilen und Zusammenführen der Segmente.
Mit der Abstraktion des Readers beginnen, nicht mit dem Format-Parser. Jedes Containerformat wird drastisch einfacher zu implementieren, wenn der wahlfreie Byte-Zugriff und die Pufferverwaltung sauber ausgelagert sind. Wir haben seinerzeit zuerst die Container-Parser geschrieben und das Reader-Interface erst nachträglich eingezogen – das resultierende Refactoring war aufwendig.
Offset-Patching muss ab Tag eins als Kernbestandteil der Testsuite verankert sein. Ein Manifest, das in C2PA-Tools grün anzeigt, aber den Media-Player zerstört, bemerken im Zweifel erst die Endanwender. Wir sichern diesen Bereich ab, indem wir jedes signierte Testvideo automatisiert mit FFprobe analysieren und Frame-Zahlen sowie Chunk-Ausrichtungen verifizieren.
Unterstützt die Implementierung fragmentiertes MP4? Das lazy Box-Parsing und das Offset-Patching decken klassische, nicht-fragmentierte MP4-Strukturen ab. Fragmentiertes MP4 (mit sich wiederholenden moof/mdat-Paaren) sowie BMFF-v2-Top-Level-Box-Hashing sind nachgelagerte Ausbaustufen, über die wir berichten, sobald die Spezifikation hierfür finalisiert ist.
Welche Dateigrößen lassen sich im Browser signieren? Die Obergrenze wird primär durch die Blob-Limits der Browser-Engines bestimmt, nicht durch unsere Bibliothek. Chrome und Firefox unterstützen Blobs weit jenseits von 2 GB. Safari agiert historisch etwas restriktiver. Wir testen regelmäßig mit 1,5 GB großen Videodateien auf mobilen iOS-Geräten.
Warum 64 MB Chunks für das Streaming, aber 1 MB für das Hashing? Das Schreiben von Streams profitiert von größeren Chunks, weil dadurch I/O-Overhead und Systemaufrufe minimiert werden. Beim Hashing hingegen steht ein kleiner, berechenbarer Speicher-Footprint an der Aufrufstelle im Vordergrund – 1 MB hält den Speicher selbst bei 2 GB großen Dateien jederzeit stabil.
Funktioniert dies nur mit Diensten von TrustNXT? Nein. Die Asset-Schicht ist Teil der Open-Source-Bibliothek c2pa-ts und signiert über das standardisierte Signer-Interface (ausführlich in unserem Signer-Interface-Beitrag). Jede Implementierung, ob Browser-WebCrypto, native Mobil-Callbacks oder serverseitige HSMs, arbeitet mit derselben Streaming-Pipeline.